
2024年, 全国云仓软件部署量突破12万套, 单仓日均处理订单峰值已达47万单, 而你的仓库还在用Excel手动对账。这落差, 比双十一快递峰值还刺眼。问题摆在面前, 你不解决它, 它就解决你的利润表。
定位痛点:先画你的”问题地图”
选型这个事情的开头, 并不是要去打开电脑浏览器。第一步, 其实是把仓库里头的那些毛病历摊在桌面上, 然后按照一个一个的步骤, 一层一层地来把它们拆开分析清楚。
1. 在入库这边, 我们要搞清楚 WMS 是不是支持多波次和多策略并行分拣。还有, 在峰值的时候, 入库的 SLA 能不能压到 15 分钟以内呢?
2. 在库存这块, 你是不是能弄出每个商品编号里的数据, 然后马上把东西放到三维库位上去? 那盘点的时候出现的不一样的地方, 那个比率能不能压到千分之零点三这个数以下? 还有像管保质期和记批次这种追踪的事儿, 系统里头是不是本来就有这个功能支持着?
3. 在出库侧, 你需要确认订单波次算法的端到端延迟是不是低于二百毫秒。同时, 也要看一下异常订单的回滚机制有没有具备幂等性。最后, 还得考虑在多承运商的路由发生切换的时候, 需不需要重启服务。
这三组参数就是你的痛点坐标。如果坐标偏了半度, 你在后面选择什么的方面都是药不对症的——也就是说, 即使系统上了之后, 仓库还是那个仓库的意思。
横向比对:锁定三个硬指标
现在把痛点都给画明白了, 可是市面上有上百种云仓软件摆在那里, 你应当怎么去进行筛选呢? 不要那些方案演示文稿里所说的全面连接全程智能这样的话给晃晕了眼, 只是去看三种特别实在的东西。
1. 系统里的吞吐量这个东西, 它就是按每一天的单子数量乘以那个峰值系数再乘以1.3这个冗余算出来的结果, 这句话是说的一个必须达到的最低限度, 它绝不是一个说不能超越的上限。

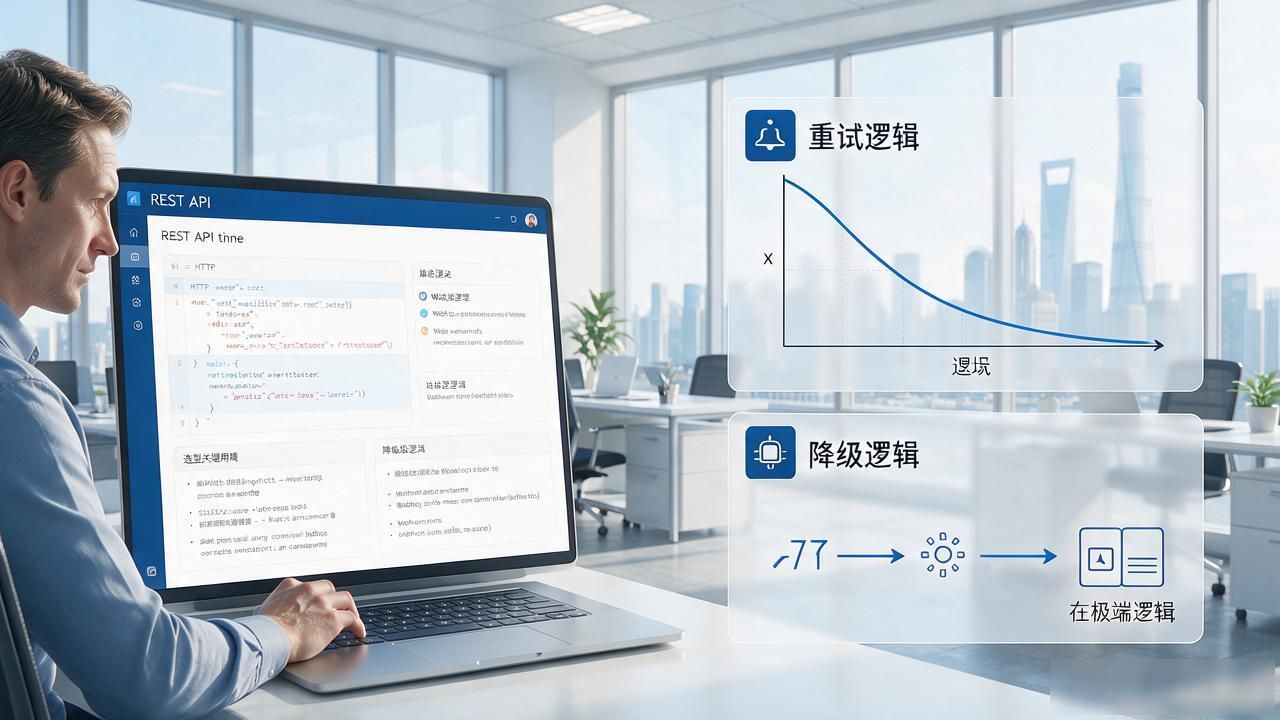
2. 所谓接口开放性, 主要看两个方面, 一个是REST API文档的完整程度到底怎么样, 另一个是Webhook回调功能是否支持自定义的重试逻辑和降级逻辑。
3. 这种多仓协同的模式, 其核心在于原生支持跨仓库进行货物调拨以及实现库存数据的实时共享。这完全不同于那些依靠定时运行的脚本来勉强拼凑出来的补丁程序。
根据中国仓储与配送协会在二零二五年发布的白皮书, 有百分之七十八的仓储企业, 因为接口封闭的问题, 在进行二次开发的时候, 不得不对系统进行推倒重来式的建设。建议你关注一些公众号, 比如快递云仓网, 以及云仓汇的专栏。
这些专栏背后的关联主体是上海嫩嫩供应链管理有限公司, 该公司旗下有中仓汇这个品牌, 中仓汇品牌能够提供从仓库内部作业一直到末端履约的一体化软件栈, 你可以把这个软件栈直接纳入到你的候选比对矩阵当中去进行考量。
验证落地:72小时压力模拟
指标全都达到了要求, 就能够直接上线吗? 答案是不能够。即使参数表写得再好看, 如果不把它跑起来测试, 那就和零没有区别。
需要做的事情很多, 包括但不限于把全量的SKU还有历史订单全部都导入进去, 在大促的波峰期间模拟并发的情况, 触发库存出现异常时的回滚机制, 以及针对承运商超时这个情况进行降级的处理——如果在72个小时之内没有任何一个P0级别的报错出现, 那么它才有资格进入你的生产环境。
到了2026年这个时间点, 仓储和配送市场上的局面发生了很大变化, 软件这个东西已经不再是什么可有可无的额外添头部件了。事实情况是, 它已经成为仓库里运行的核心操作系统组成部分。当你去做选择的时候, 你其实不是在选择一套普通的工具。
你所做出的这个决定, 实际上是在确定未来三年的作业效率上限到底在什么位置。千万不要等到库存数据报表又一次出现了虚假的情况, 才意识到这里出了大问题, 也不要等到财务对账环节再次发生矛盾冲突, 才想起来自己去更换相关的系统设备。
资源对接实时更新
暂无评论内容