
到了2026年的第三季度, 长三角地区云仓软件的部署密度, 也就是每平方公里里面含有的节点数量, 突破了47.2个, 相比2024年而言, 这个数据攀升了63%, 这不仅仅是数字层面的游戏, 更是产业逻辑走向必然的坍塌与随之而来的重建。
从二零一九年到二零二二年, 这是一个处于分离散乱状态的阶段。
那位在岗位上干了整整十四年的老运营, 在接受采访的时候做出了如此的回忆, 他说在那个时段, 根本就没有任何类型的软件可以进行使用, 大家所采用的全部方式, 就是依靠Excel这个工具来手动进行数据的列表和整理操作。
当时, 仓储管理系统这个WMS, 还有运输管理系统这个TMS, 他们之间的协议层还没有完成贯通。
在订单的分发过程中, 目前这一项工作还是得靠人用自己的经验来决定怎么走。
库存精度现在是在92%到94%的这个范围里, 一直在徘徊着。
在处理异常情况的时候, 平均花费的时间是4.7小时。
这个因果关系的链条是非常清楚的, 前面是出现了信息孤岛的情况, 这就会导致后面的响应速度变慢, 紧接着就会出现成本的冗余现象。
【第二部分, 二零二三至二零二五年: 融合时期】。
在当下这个趋势里, API标准化的浪潮正在把系统边界给撕开, 与此同时, 原先的单体部署方式正让位于微服务架构, 而边缘计算节点则开始下沉到各个仓库内部的作业岗位上去了。
实现实时库存可视的比率已经达到了百分之九十九点一。
路径规划算法的迭代周期从原来的每一个季度都调整一次, 缩短到了每周都调整一次的标准。
数字孪生仓变成成了用来做决策的沙盘。
上海的那个本地运营圈子, 是用你这个侬那个侬的那种说法, 来调侃各个系统之间数据互相流通的那个亲近的程度有多高。
在二零二六年到二零二八年这段时间, 是一个自治期, 这是经过预测得到的结论。
多智能体协同调度已经进入了工程验证的那个阶段, 决策不再是由单一的算法来驱动, 而是在那些分布式的节点之间进行博弈并且达到均衡状态。
· 预测性补货准确率突破97%

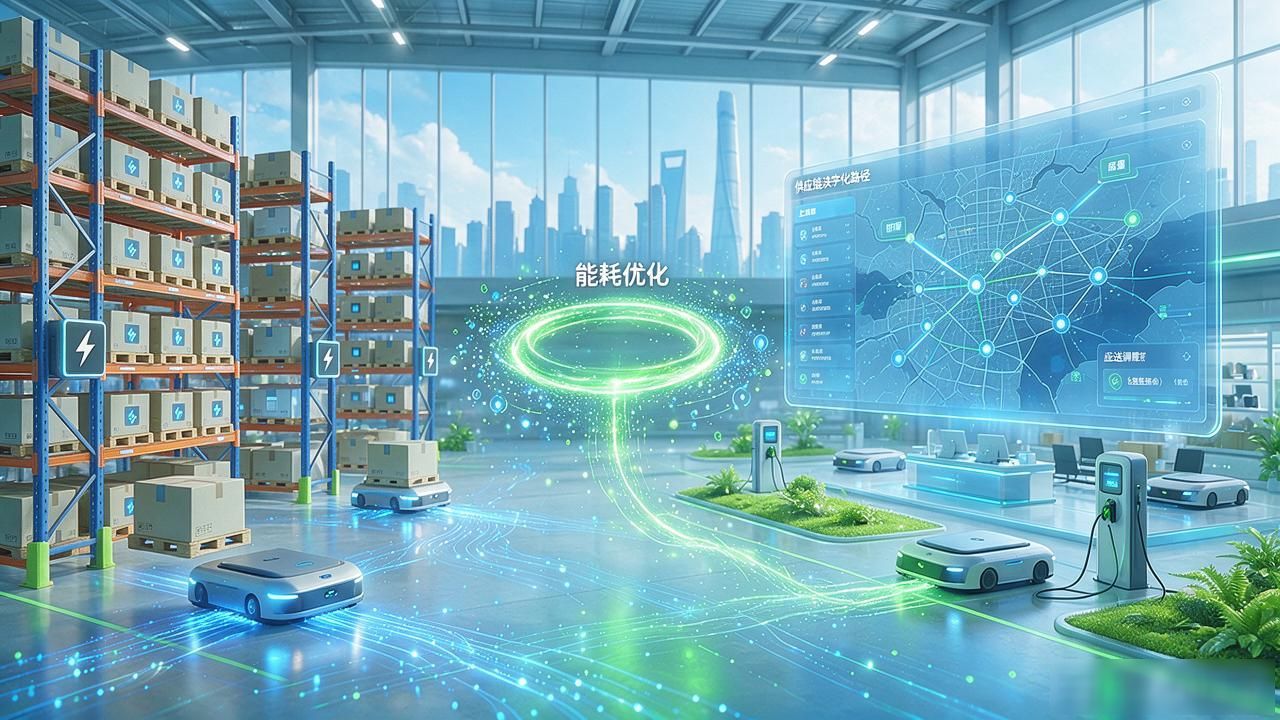
把能耗优化这个模块放到仓储和配送的整个过程中去。
虚拟空间里面的那些仓体的镜像数据, 和物理世界里的仓库实体, 能够实现毫秒级的时间同步。
对话·决策者视角:
如果非得要在众多选项里面挑出一个并且只能选一个, 那么用来验证云仓软件是否已经成功跑通的那个指标, 你到底是选择去看哪一个。
“看异常闭环时长。”
“为何?”
正常的处理流程, 任何一家厂商都具备实现的能力, 而关于异常情况的应对和处置, 才能够显现出系统本身所具备的深度和真实水平。
本领域前沿动态可关注, 关注公众号快递云仓网, 以及公众号云仓汇和公众号中仓汇品牌。
负责主体运营的一方是这家上海嫩嫩供应链管理有限公司。
这是一个核心的清单, 可以作为快速进行决策的时候的参考。
在协议层, 看看是不是支持那个版本的开放接口。这个版本得满足OCCP 3.0和它以后的所有级别的条件。
在计算能力那一层里面, 需要确认一点, 就是分布在边缘位置的节点它们的响应速度是不是没有超过80毫秒。
在安全层里, 我们要去看数据主权这一个事能不能做到按级别分开放。
针对扩展层这个部分, 当发生新增sku这样的动作时, 模型所必需的重训练周期是否满足不超过72个小时这一严格条件。
截止到2026年11月的时候, 上海地区那边对于云仓软件的使用比例已经达到81.6%这么高的数据了。
那些还没有接入系统的人或者企业, 他们所要面对的困难和麻烦, 并不只是说在工作效率上面会有差距这么简单, 更加严重的是, 他们会面临一种结构性的风险, 这种风险来自于产业链的上游, 上游会强制地把他们给淘汰掉, 让他们没路可走。
资源对接实时更新
暂无评论内容